2026年
CoRL 2026 论文导读|ELAN4D:用机器人自身的未来轨迹增强 VLA 泛化
CoRL 2026 已录用 · Vision-Language-Action · 4D 监督
论文题目:ELAN4D: Embodiment-Centric 4D Supervision for Vision-Language-Action Models via Plug-and-Play Adaptation。
机器人在训练场景里完成任务,并不代表换一个背景、相机视角或物体位置后仍能成功。ELAN4D 的思路是:训练时,让动作策略同时学习机器人自身接下来会怎样运动,用低成本的未来轨迹监督增强 VLA 的泛化能力。
合作团队亮点:莫凡参与该项合作研究。论文作者包括上海交通大学的 Bowen Yang 与 Junchi Yan(严骏驰);上海交大人工智能学院官网确认严骏驰为教授,研究方向为机器学习及其交叉应用。完整作者和论文署名机构列于文末。
一分钟读懂 ELAN4D
- 监督什么:机器人关节、末端等关键点未来的 3D 位移轨迹。这里的“4D”指三维空间随时间的变化。
- 怎么得到:利用示教轨迹中的本体状态与已知运动学链,通过正运动学计算,不依赖外部视频追踪器生成机器人轨迹。
- 怎么接入:在动作专家上增加 ControlNet 风格分支,用梯度隔离和零初始化残差投影接入监督。
- 推理时:移除轨迹解码器,保留学习到的控制分支,维持原有图像、语言、本体状态到动作的接口。
下图概括了本文试图平衡的三个问题:分布外鲁棒性、4D 轨迹的预处理成本,以及辅助任务对预训练表征的干扰。
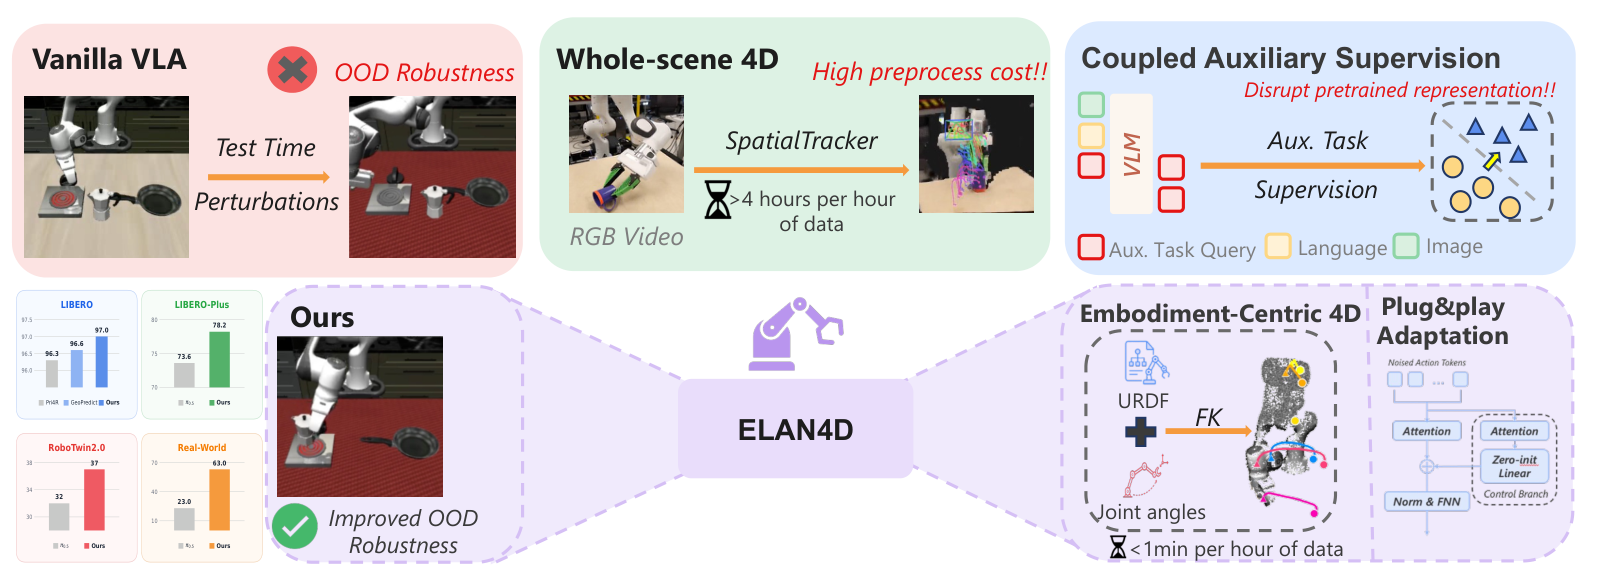
图 1|ELAN4D 的动机与整体思路。原文 Figure 1,PDF 第 2 页。 查看高清原图
01|从“当前看到什么”到“执行后会怎样”
VLA 将视觉、语言和动作连接起来,让机器人根据观测和指令输出动作。论文关注的难点是:策略如果主要依据当前观测回归动作,可能没有充分学习动作带来的未来空间变化,在新视角、新背景或新布局下更容易失效。
预测整幅未来图像会包含大量静态背景与外观变化;对整个场景生成稠密 3D 轨迹又可能依赖昂贵的视频追踪和重建。ELAN4D 选择一个更聚焦的监督对象:机器人本体的运动。
02|用正运动学生成 4D 监督
对于示教轨迹中的关节状态 q(t),已知的机器人运动学模型能够算出关键点位置:pₖ(t) = FKₖ(q(t))。将未来关键点位置减去当前位置,就得到相对位移 ΔP(t+h) = P(t+h) − P(t)。把多个未来时刻串起来,监督目标的形状是 H × K × 3:预测时域、关键点数、三维坐标。
这种目标来自已有的机器人状态记录,不受相机遮挡直接影响。文中 LIBERO / LIBERO-Plus 使用 8 个关键点,RoboTwin2.0 使用 14 个,真实机器人使用 7 个。论文报告,处理一小时数据,视频追踪流程约需 4 GPU 小时,而本体轨迹可在约一分钟 CPU 时间内得到;这是文中设置下的监督信号预处理成本比较,并非整套模型训练只需一分钟。
03|即插即用分支:辅助监督如何进入动作模型?
论文以 π₀ 和 π₀.₅ 为基础,两者使用视觉语言骨干和基于条件流匹配的动作专家。ELAN4D 在动作专家旁增加残差控制分支,经零初始化投影把特征加回主路径,使训练初期新增残差接近零。
一个轻量轨迹解码器结合控制特征与当前机器人关键点,预测未来位移。训练目标为 L = L_act + λ_track L_track:动作损失监督动作生成路径及控制分支;轨迹损失更新控制分支与轨迹解码器,并通过 stop-gradient 避免直接回传到预训练 VLM 和原有动作分支。
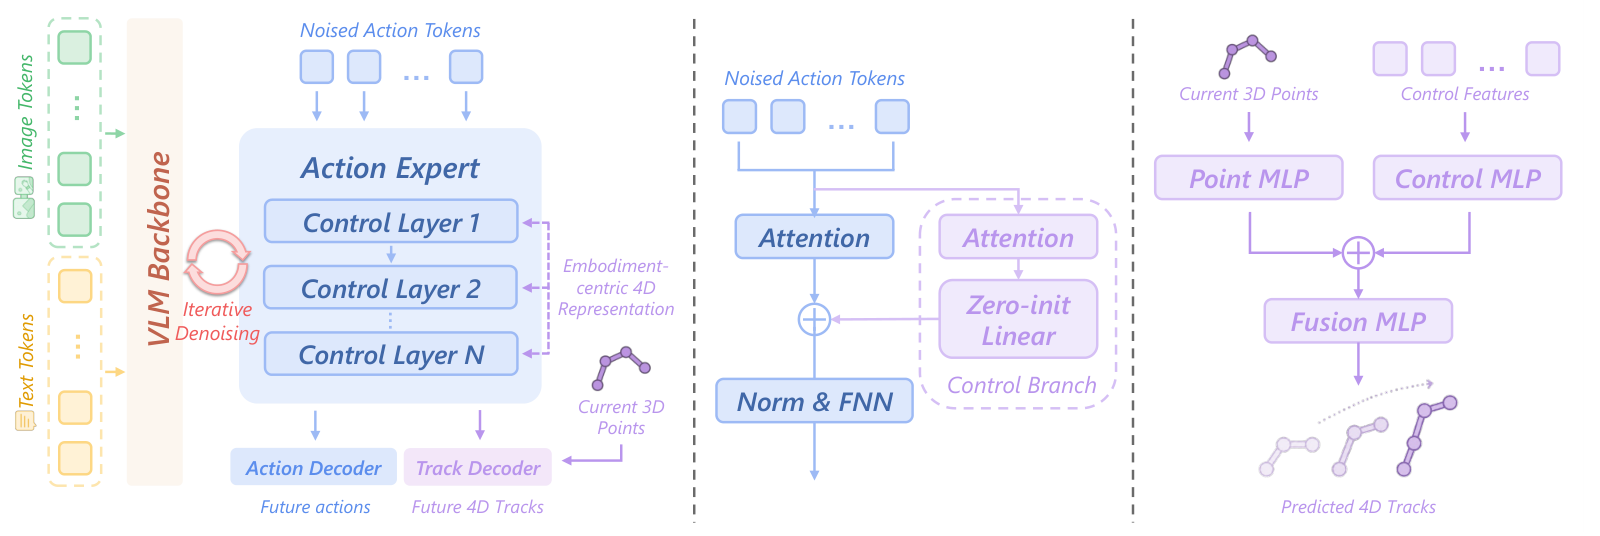
图 2|动作专家、残差控制分支与轨迹解码器。原文 Figure 2,PDF 第 4 页。 查看高清原图
部署时保留什么?轨迹解码器及其专用 3D 关键点输入被移除;新增残差控制分支仍保留在动作专家中。策略继续接收图像、语言和本体状态并输出动作。因此,“接口不变”不等同于“推理计算量完全不变”,也不意味着预训练骨干在全部训练目标下都被冻结。
04|仿真结果:主要收益体现在分布外泛化
在接近饱和的原始 LIBERO 上,整体成功率的提升较小:π₀ 从 94.2% 到 95.0%,π₀.₅ 从 96.9% 到 97.0%。更明显的收益出现在带系统扰动的 LIBERO-Plus:
- π₀:53.6% → 67.6%,提升 14.0 个百分点。
- π₀.₅:73.6% → 78.2%,提升 4.6 个百分点。
- 训练数据:两项 LIBERO 评测均由原始 LIBERO 示教训练,没有使用 LIBERO-Plus 的增强数据训练。
下表列出不同扰动维度和任务套件。整体平均提升,并不表示每一个子项都同时领先。
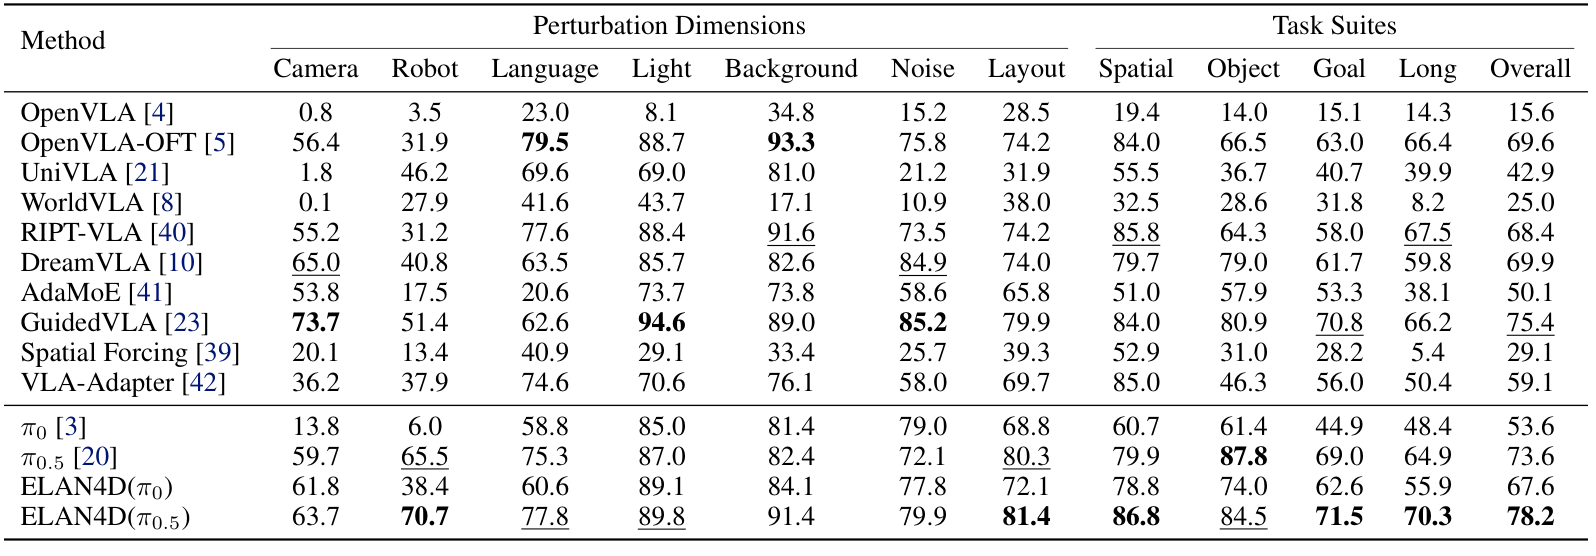
图 3|LIBERO-Plus 成功率(%)。原文 Table 1,PDF 第 7 页;上文增量按百分点计算。 查看高清原图
在 RoboTwin2.0 的 8 类未见双臂设置中,π₀ 的整体成功率由 12% 提升至 15%,π₀.₅ 由 32% 提升至 37%。论文报告每项任务评测 100 次;Dump Bin、Lift Pot 等空间操作任务的改善较突出。这些结果是文中基准与设置下的对比,不代表对所有机器人任务的性能保证。
05|真实机器人:干扰、位置变化与连续装配
真实评测使用 AgileX Piper 机械臂,设置三类任务:干扰物环境下的水果抓放、未见位置的纸杯叠放,以及两阶段积木装配。每类任务使用 50 条专家示教训练,评测 20 次。
- 视觉鲁棒性:π₀.₅ 从 50% 提升至 80%。
- 空间泛化:从 15% 提升至 65%。
- 连续操作:从 5% 提升至 45%。
图中总体成功率由约 23% 提升至约 63%。这些结果说明,在所测试的场景中,机器人自身的未来运动监督能够帮助策略应对干扰和误差累积;评测仍受任务种类和试验次数限制。
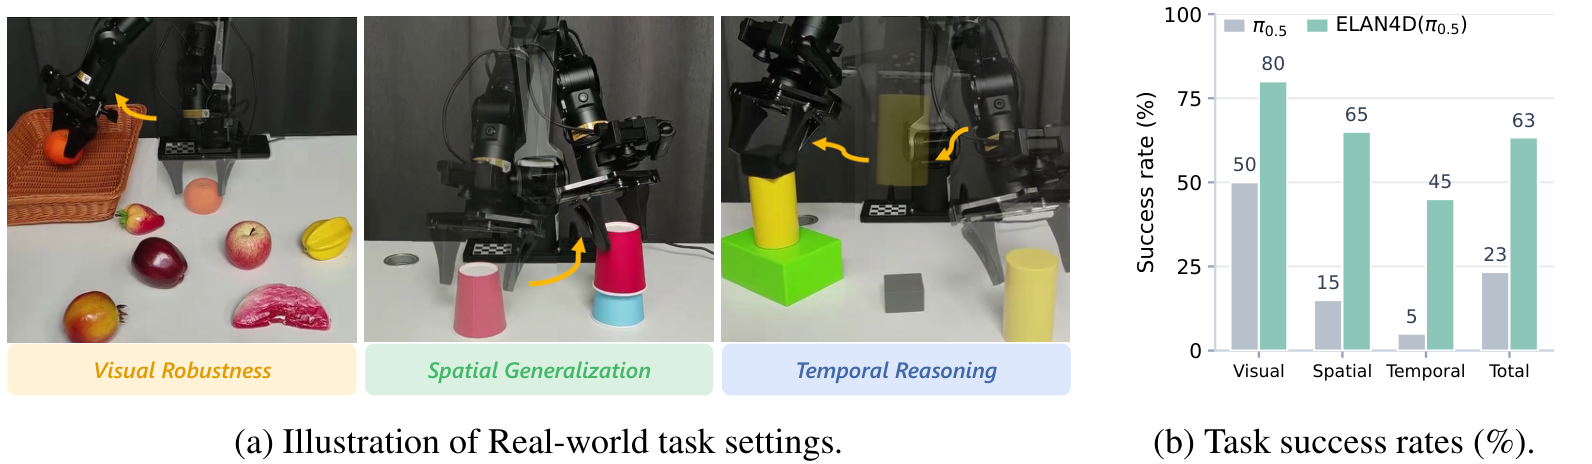
图 4|真实任务示意与成功率。原文 Figure 4,PDF 第 7 页。 查看高清原图
06|消融实验:收益究竟来自哪里?
仅添加控制分支、去掉 4D 轨迹损失,LIBERO-Plus 得分为 73.3%,接近 π₀.₅ 基线的 73.6%;完整方案为 78.2%。这支持收益与 4D 监督有关,而不只是多了一些参数。
把轨迹预测查询直接放进 VLM 的变体得分为 66.8%,低于独立控制分支方案。CKA 分析也显示,这个变体的 VLM 表征偏移更明显,为梯度隔离的设计提供了实验支持。
使用模拟器真值获取更丰富的整场景轨迹,得分可以达到 79.3%,比机器人本体方案高 1.1 个百分点。作者选择本体关键点,是在监督丰富程度与获取成本之间作取舍。
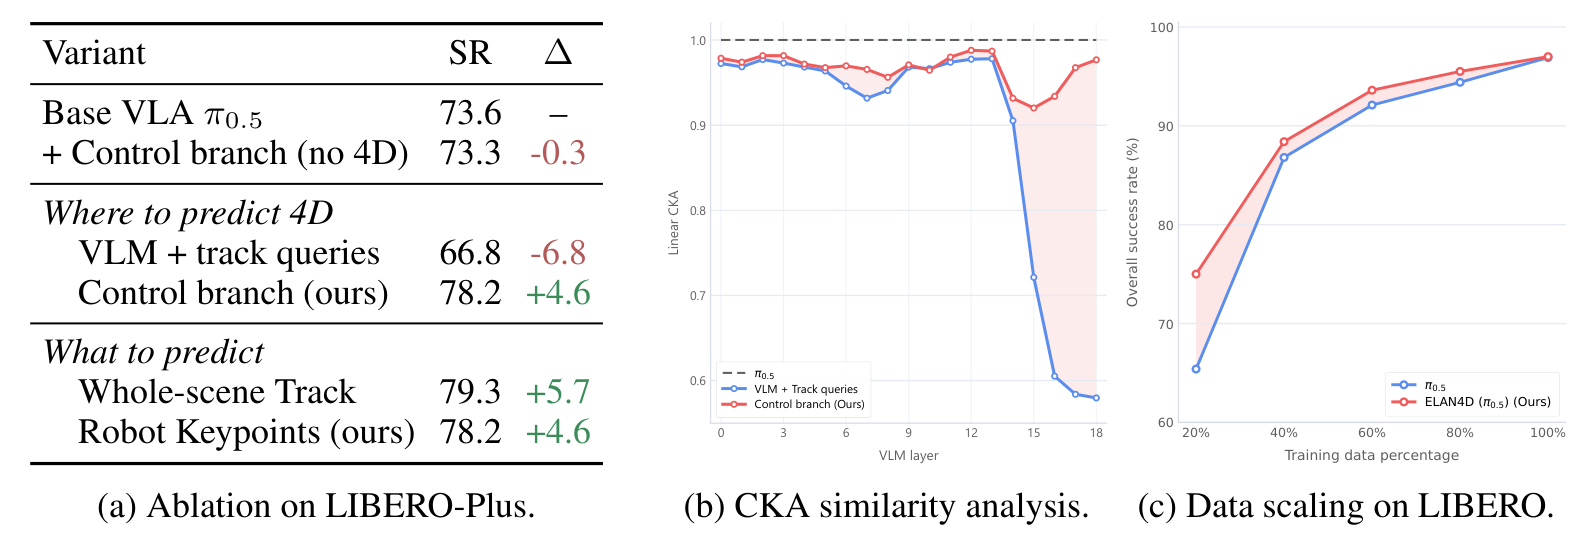
图 5|监督位置、监督目标与数据效率消融。原文 Figure 5,PDF 第 8 页。 查看高清原图
07|对 VLA 开发有什么启示?
这项工作的价值在于将容易获得的机器人状态记录转化为预测性训练信号:示教不只告诉模型“做什么动作”,也能监督这些动作对应的本体空间变化。其设计适合启发已有 VLA 的训练改进。
- 需要可靠的本体记录和运动学模型:关键点监督依赖记录的机器人状态及已知运动学链。
- 不直接监督整个外部世界:当任务主要取决于外部物体运动、可变形物体或复杂接触时,稀疏本体轨迹可能不足。
- 训练与推理边界要分清:未来轨迹用于训练监督,推理移除轨迹解码器,但控制分支保留。
- 结论来自报告的实验设置:论文没有证明其对所有模型、机器人形态或每个细分任务都有效。
08|合作作者与机构
完整作者(按论文顺序):Zeyuan He, Bowen Yang, Zhirui Fang, Keru Zhou, Lei Jiang, Jingjing Qian, Fan Mo, Junchi Yan, Philip Torr, Xiu Li, Li Jiang, Jialin Yu。
上海交通大学合作作者:Bowen Yang 为共同第一作者之一;Junchi Yan 即严骏驰教授。根据上海交通大学人工智能学院官方教师主页,严骏驰为教授,主要研究机器学习及其交叉应用。该主页亦列有其 ICML 董事会成员等学术服务信息。
以下机构按 arXiv v1(2026 年 5 月 28 日)论文首页署名对应列出:
- 牛津大学 Torr Vision Group:Zeyuan He、Philip Torr、Jialin Yu。
- 香港中文大学(深圳):Zeyuan He、Jingjing Qian、Li Jiang。
- 清华大学:Zhirui Fang、Keru Zhou、Xiu Li。
- 上海交通大学:Bowen Yang、Junchi Yan(严骏驰)。
- 伦敦大学学院(UCL):Lei Jiang。
- 剑桥大学:Fan Mo(莫凡)。
论文标注 Zeyuan He、Bowen Yang、Zhirui Fang、Keru Zhou 为共同第一作者,Zhirui Fang 为项目负责人,Lei Jiang 与 Li Jiang 为共同指导,Jialin Yu 为通讯作者。
论文与会议资料
录用状态:已录用 CoRL 2026。本文导读依据公开 arXiv v1 整理,录用状态由课题组确认;未指定 Poster、Oral 等报告形式。
CoRL(Conference on Robot Learning,机器人学习大会)是聚焦机器人与机器学习交叉研究的年度国际会议。CoRL 2026 官网公布主会于 2026 年 11 月 9–11 日在美国得克萨斯州奥斯汀举行,11 月 12 日为专题研讨会。
arXiv 摘要与版本记录 · 阅读公开论文 PDF · 严骏驰教授官方主页
配图取自论文原图或原表,图注注明编号与页码;成功率和成本数据均按论文报告的实验条件解读。