2026年
实验室论文获 NeurIPS 2026 主会 Poster 录用|论文导读
NeurIPS 2026 Main Track · Poster · CCF A 类会议
论文题目:Memorization Is Folding: Topological Signatures of Noisy-Label Learning。
训练损失不断下降,模型究竟在学可泛化的规律,还是在记住错误标签?这篇论文从表征空间中的“环”出发,追踪噪声监督如何改变网络内部的结构,并探索能否更早发现这种变化。
一分钟读懂这篇工作
- 研究对象:噪声标签训练过程中,网络倒数第二层表征的拓扑结构怎样变化。
- 核心观察:在部分设置中,干净表征的环结构更快消退,而噪声表征保留得更久,形成干净与噪声轨迹的“拓扑交叉”。
- 实际价值:把拓扑量作为早期、总体层面的训练诊断信号;噪声水平估计需要为每个数据集—模型组合单独校准。
01|问题:为什么只看 loss 还不够?
深度网络有能力拟合带噪声的标签。随着训练推进,损失下降可能同时包含两件事:学习数据中的规律,以及适应错误甚至彼此矛盾的监督。因此,想理解模型如何走向记忆,仅看最终准确率或一条损失曲线,往往无法直接看见内部表征发生了什么。
论文把视角移到倒数第二层表征。可以把每个样本的特征向量看成高维空间中的一个点,所有点共同组成一片“点云”。研究关注这片点云中的连接和环结构,如何随训练变化。
02|方法:用持续同调追踪表征的“形状”
持续同调会在不同尺度下连接点云,观察哪些结构只是短暂出现,哪些能够持续存在。这里,H₀ 描述连通分量,H₁ 描述环结构。论文报告,所研究噪声记忆过程中的关键区分信号主要出现在 H₁。
作者将保留下来的有限 H₁ 条带寿命相加,得到 Φ(t) = ∑(d − b):b 和 d 分别是一个环在尺度变化中出现、消失的位置。计算时去掉寿命不超过该检查点最长有限寿命 1% 的短条带,从而减弱短暂结构的影响。
具体流程是:在选定训练检查点将模型切到评估模式,提取测试集激活;通常随机采样 300 个点,以欧氏距离构建 Vietoris–Rips 持续同调,并用 Ripser 计算。随后比较干净标签与噪声标签训练的 Φ 轨迹。文中报告的研究规模超过 900 次训练和 8,000 次持续同调计算。
“折叠”是一种解释表征变化的几何视角。它关注网络适应矛盾监督时如何改变或保留环结构,不应把 Φ 当成所有模型都能直接横向比较的绝对分数。
03|发现一:部分模型会出现比验证损失更早的轨迹交叉
下图蓝线对应干净训练,红线对应 50% 噪声训练。在交叉出现的设置中,干净轨迹后期下降更快,而噪声轨迹维持较高水平,最终出现 ΔΦ(t) = Φ噪声(t) − Φ干净(t) 从负变正。
论文给出的 CIFAR-10 / ResNet-18 示例中,拓扑交叉约发生在第 25 个 epoch,验证损失的拐点约在第 45 个 epoch。这说明拓扑能够在这些设置里提供较早的结构变化提示。原文只采样了 14 个检查点,因此交叉时刻是近似值。
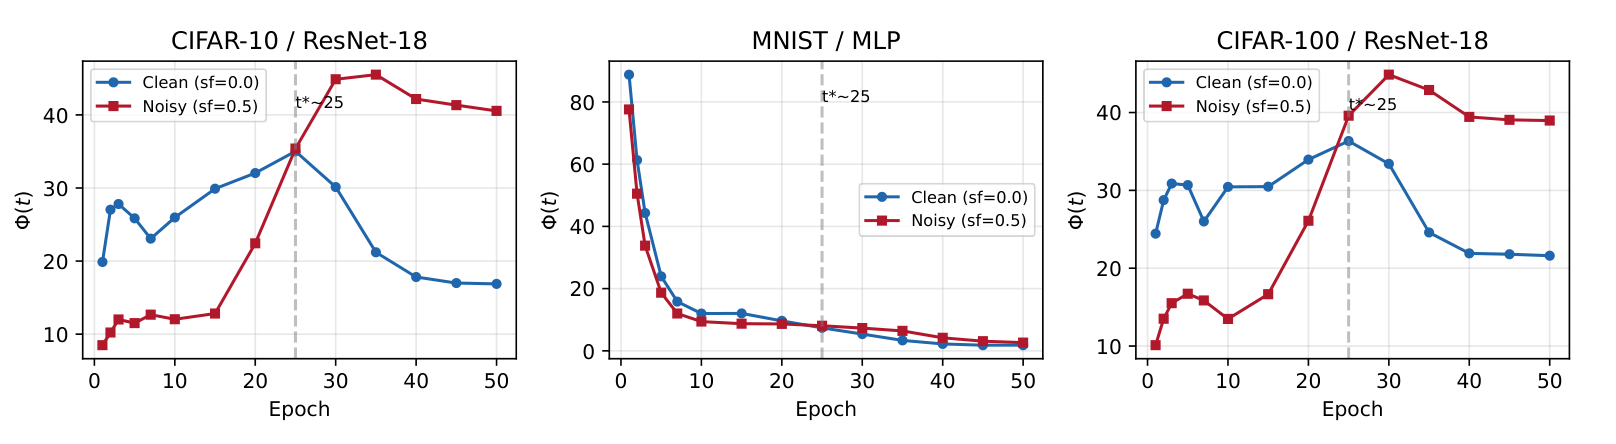
图 1|干净与噪声训练的代表性 Φ 轨迹。原文 Figure 5,PDF 第 7 页。 查看高清原图
但交叉有条件:干净信号需要消退,噪声信号下降得更慢,而且初始差距要能在观察时间内闭合。FashionMNIST 的部分设置虽然前两项趋势成立,仍未在 50 个 epoch 内交叉。作为留出验证,ResNet-34 / CIFAR-10 的干净轨迹没有进入消退状态,作者据此预测不交叉,并在 9 次运行(3 次干净参考、6 次噪声训练)中得到支持。
04|发现二:关键不只是噪声比例,还有标签矛盾的结构
相同的错误比例,不一定带来相同的表征变化。作者在 CIFAR-10 / ResNet-18 上,分别向选定的 5 组更易混淆和 5 组较不易混淆类别注入 50% 标签噪声,各使用 10 个种子。第 10 个 epoch,前一组的 Φ 高约 15.9%(19.0±1.5 对 16.4±0.9,p=0.0002);到后期,这个差异减弱。
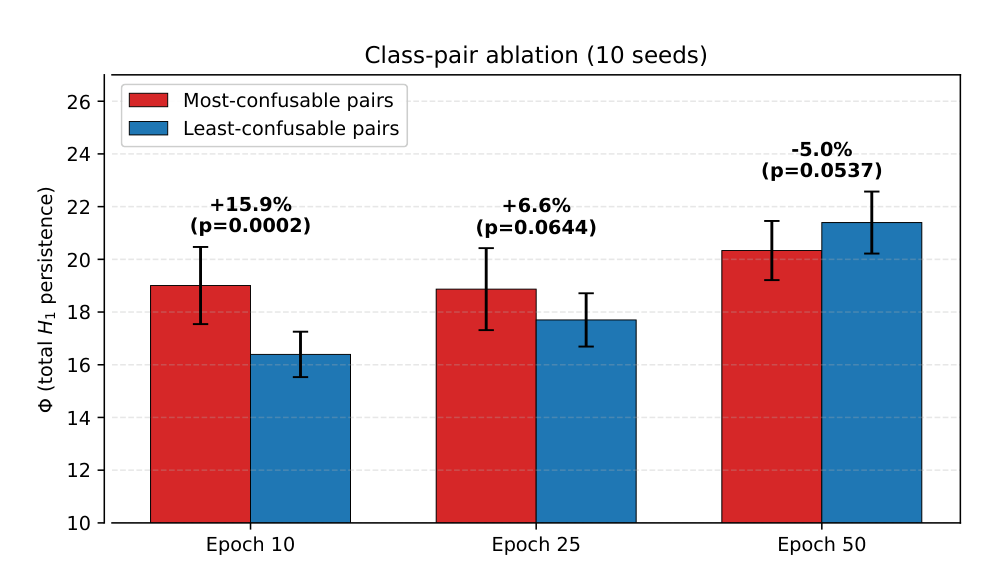
图 2|固定噪声比例、改变受扰动的类别对。原文 Figure 3,PDF 第 5 页。 查看高清原图
进一步比较噪声类型时,可由相对简单边界调整吸收的非对称类别混淆,折叠信号较弱;实例依赖噪声和真实人工标注噪声,则表现出更强的局部矛盾相关信号。CIFAR-10N 的 worse 划分约含 40% 噪声,论文报告图中相应 H₁ 信号从第 10 到第 50 个 epoch 约由 12 增至 27。不同架构的时间尺度也不同:ViT-Tiny 的噪声类型差异到第 50 个 epoch 才明显出现。
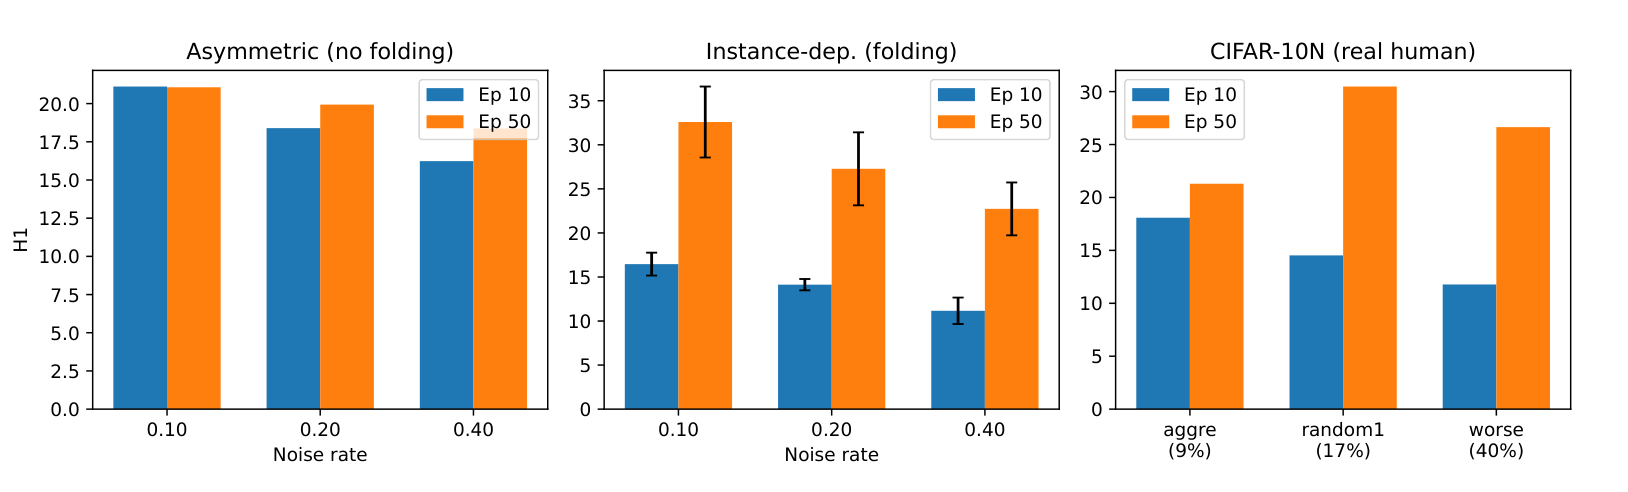
图 3|非对称噪声、实例依赖噪声与 CIFAR-10N 人工噪声的比较。原文 Figure 10,PDF 第 20 页。 查看高清原图
05|发现三:拓扑与常用统计量提供互补信息
论文也比较了激活方差、范数、损失、准确率和内在维度等统计量。一个重要结论是:激活方差等指标在总体比较中的平均判别力更强,拓扑信号的意义在于揭示额外的结构变化及其时序。
在早期检查点,控制相关统计量后,Φ 仍包含与噪声水平有关的信息;到第 50 个 epoch,它相对于训练准确率的独特信息减弱,但相对于测试损失仍保留信号。下图展示了这种随训练阶段变化的互补关系。
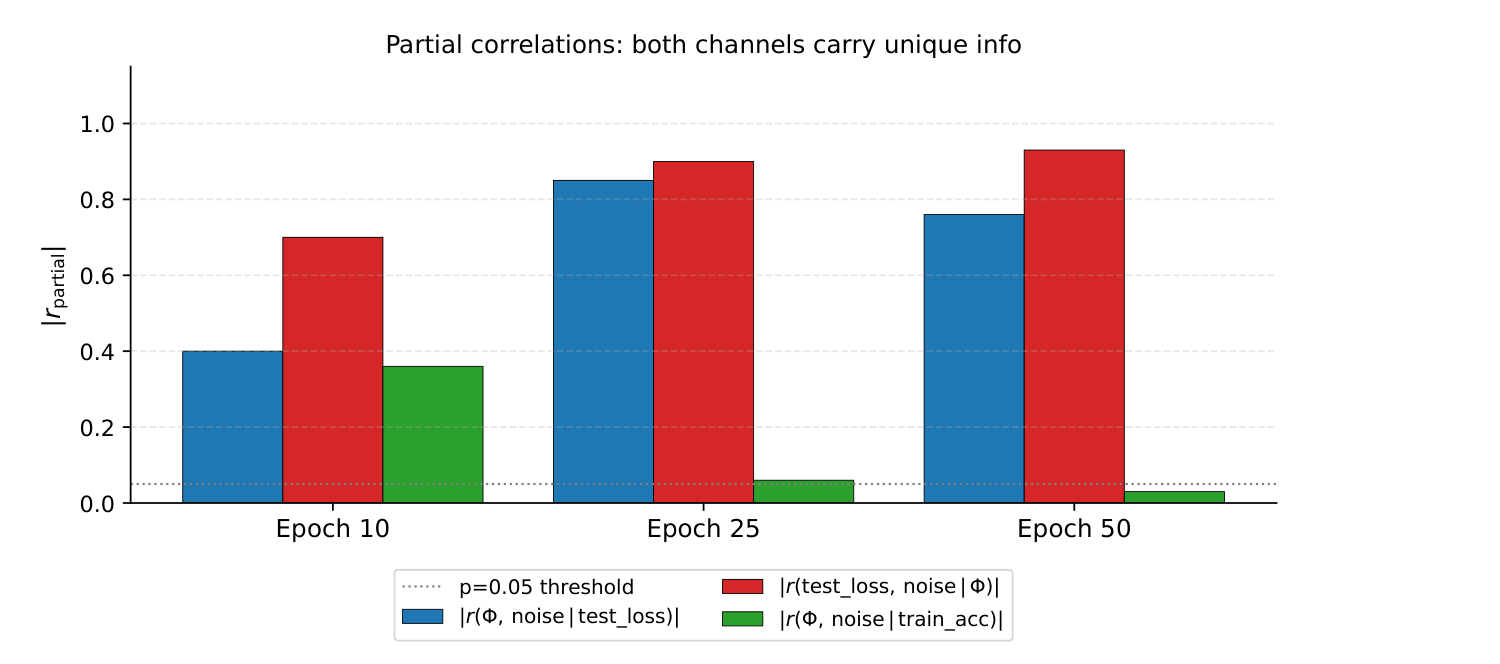
图 4|不同训练阶段的偏相关结果。原文 Figure 2,PDF 第 4 页。 查看高清原图
06|一个反向检验:grokking 时会“展开”吗?
Grokking 指模型在训练集上已拟合得很好之后,经过较长训练才突然表现出泛化能力的现象。论文在模加法、模乘法任务上,使用两个素数设置和每组 3 个种子,共考察 12 次运行。
其中 10/12 次在 grokking 转变期间出现 Φ 下降,另外两次近似持平。这与“从记忆转向可泛化结构时发生展开”的解释相符,但证据目前来自模运算任务,不能直接推广到所有 grokking 场景。
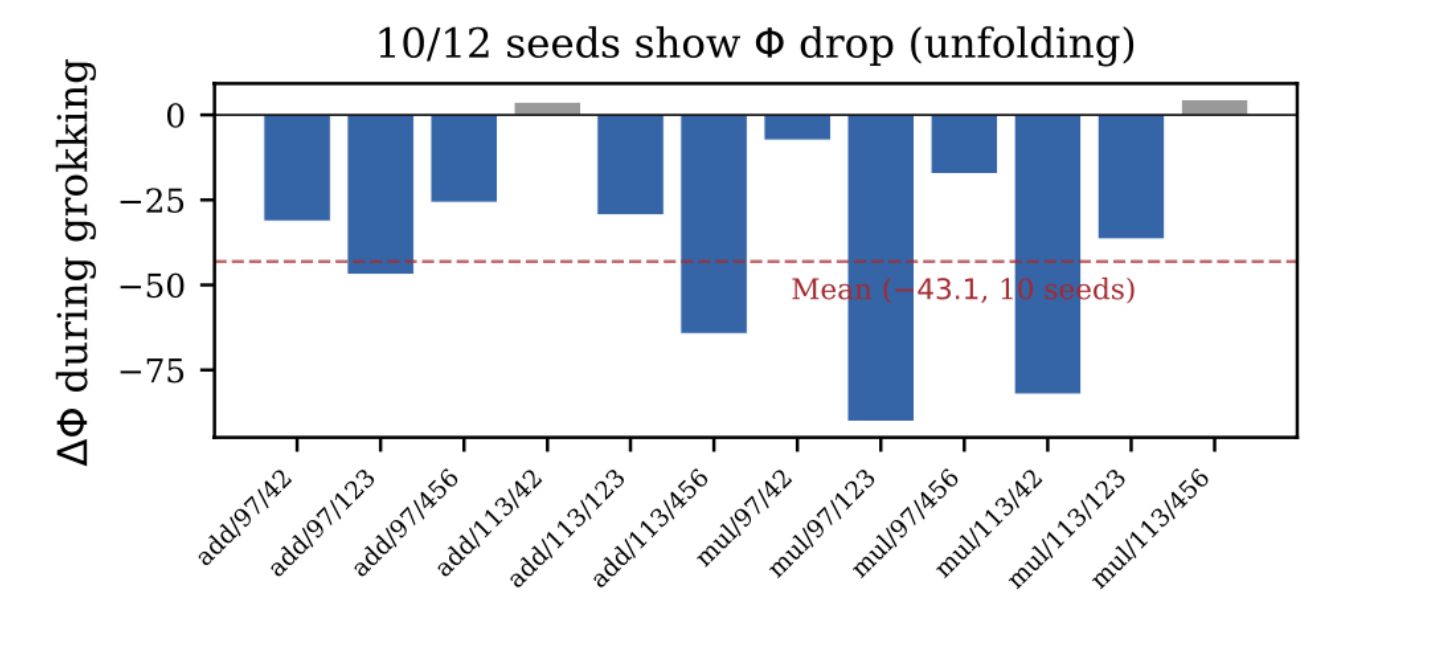
图 5|12 次模运算运行在 grokking 前后的 Φ 变化。原文 Figure 8,PDF 第 19 页。 查看高清原图
07|能拿来做什么?早期估计总体噪声水平
论文探索了使用第 10 个 epoch 的 Φ(10) 估计总体噪声程度。六个测试配置分别拟合校准关系后,报告的 R² 为 0.943–0.987,平均约 0.962。
这里的校准条件不能省略:每条数据集—模型流水线都需要干净参考训练,以及已知噪声比例的训练结果。测量针对样本群体,不要求逐个样本的干净标签;R² 也不是逐样本错标检测准确率。在 AG News / DistilBERT 上,Φ 与噪声的关系方向与视觉设置相反,因此视觉上的校准公式不能直接搬到文本任务。
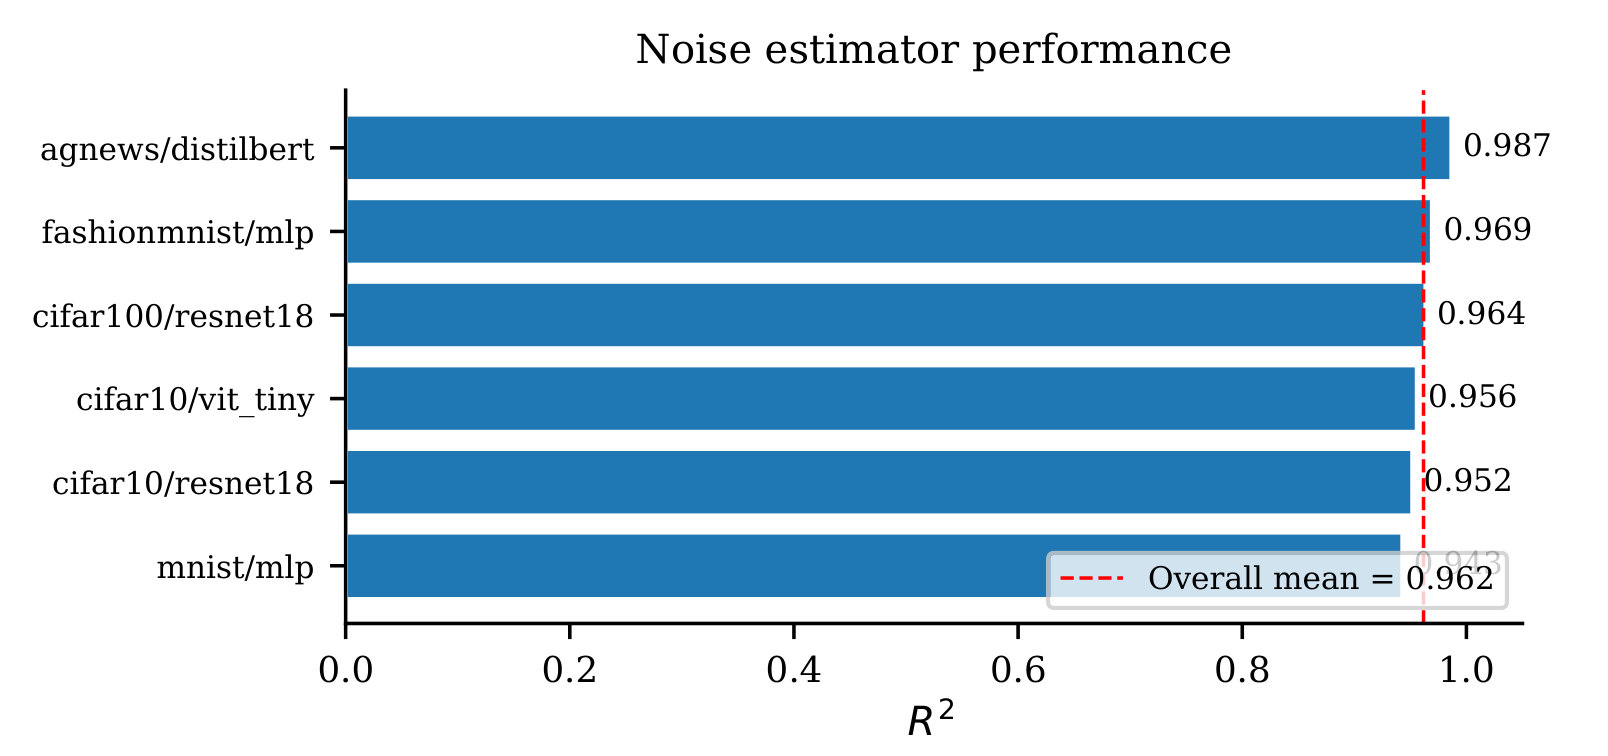
图 6|六条流水线分别校准后的拟合结果。原文 Figure 11,PDF 第 20 页;这是总体噪声水平拟合的 R²。 查看高清原图
08|读完之后,哪些结论值得带走?
这项工作为观察训练过程增加了一个拓扑视角:除了记录 loss 和 accuracy,还可以检查表征中的稳定环结构怎样演化。它为噪声数据审计、训练过程分析和后续方法设计提供线索。
- 交叉不是普遍规律:是否发生取决于轨迹演化、模型与数据,以及观察的训练时长。
- 数值依赖尺度和配置:Φ 使用原始激活的欧氏寿命,表征缩放会改变绝对数值;跨任务需要重新校准。
- 这是总体诊断:它不能直接列出“哪些训练样本标错了”,也不能把 Φ 越低理解成最终准确率越好。
- 主要证据仍是实验:文中的分段线性论证有明确假设,不能视作覆盖 BatchNorm、残差网络等所有深层架构的普适证明;完整 ImageNet 等更大范围仍有待检验。
一句话总结:噪声记忆会改变表征的拓扑轨迹;理解这种变化,需要把“环结构、训练阶段和数据—模型配置”放在一起看。
以上导读依据提供的论文稿件整理;配图取自论文原图,图号与 PDF 页码见各图图注。
录用概况
实验室论文 Memorization Is Folding: Topological Signatures of Noisy-Label Learning 获 NeurIPS 2026 Main Track(主会)录用,展示形式为 Poster(海报)。
论文题目聚焦噪声标签学习中的记忆与拓扑特征。
关于 NeurIPS
NeurIPS(Conference on Neural Information Processing Systems,神经信息处理系统大会)是机器学习与人工智能领域的重要国际学术会议。会议创办于 1987 年,是跨学科的年度会议,包含邀请报告、同行评审论文的口头与海报展示、教程和专题研讨会。
在中国计算机学会(CCF)的人工智能领域推荐目录中,NeurIPS 列为 A 类国际学术会议。参见 CCF 官方推荐目录。
主会录用信息
根据课题组提供的录用通知,NeurIPS 2026 主会共有 30,709 篇有效投稿,录用 7,900 篇,录用率为 25.7%。本论文的录用形式为 Poster。
录用结果及上述数字依据课题组提供的通知整理。会议介绍参考 NeurIPS 官方介绍。